Le besoin métier
Le support ferme beaucoup de tickets, mais les utilisateurs parlent encore des mêmes blocages.
Le nombre de tickets traités mesure une activité. Il ne dit pas si la facturation fonctionne au moment de la clôture ni si les incidents reviennent. Le responsable métier attend une explication de l’impact, une priorité et une date de résolution.
Le reporting IT rapproche le fonctionnement réel des services, la charge de support et les actions de fiabilisation. Il doit être compréhensible sans connaître les outils de supervision ou les catégories techniques.
La démarche en images
Créer ce reporting en quatre étapes
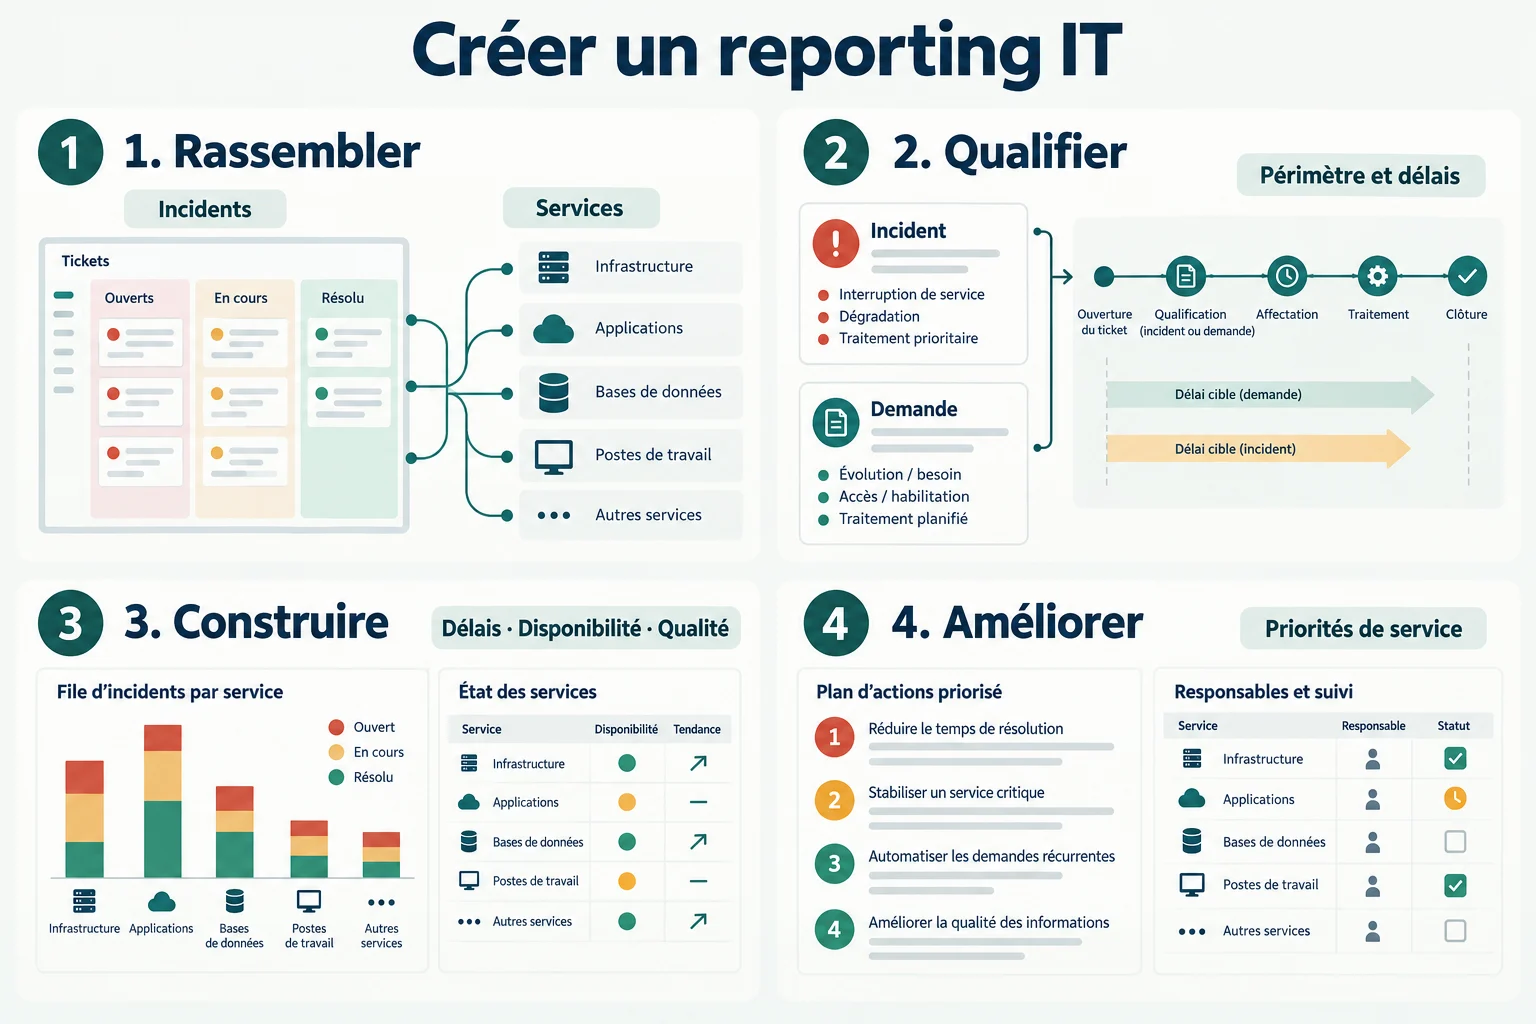
- Rassembler
Réunir tickets et mesures des services utiles à l’activité.
- Qualifier
Séparer incidents et demandes, puis définir les délais et exclusions à appliquer.
- Construire
Calculer les délais, le stock de tickets et la disponibilité avec leur couverture de mesure.
- Améliorer
Prioriser les actions selon les impacts métier et attribuer leur suivi.
Définir le service rendu, les audiences et les fenêtres de mesure
Listez les services avec un propriétaire métier et informatique. Pour chacun, précisez ce qui doit fonctionner et quand : horaires ouvrés, période de clôture ou fonctionnement continu. Documentez les priorités, le traitement des maintenances et les éventuelles pauses de décompte.
Préparez une vue quotidienne pour le support, une revue hebdomadaire des problèmes persistants et une synthèse mensuelle pour la direction. Un objectif de service interne et un engagement contractuel ne sont pas interchangeables ; leurs définitions doivent être explicites.
- Incident : interruption ou dégradation d’un service, selon votre classification.
- Demande : besoin standard d’accès, de matériel ou de prestation.
- Problème récurrent : cause à analyser, liée éventuellement à plusieurs incidents.
Séparer les tickets des observations de disponibilité
Une ligne de Tickets représente un ticket unique. L’historique des changements de statut permet de reconstituer la situation à une date passée. Gardez les demandes dans la source mais filtrez explicitement les incidents pour les indicateurs de résolution.
La supervision apporte une seconde table, Observations, au grain service–intervalle. Ne joignez pas directement chaque ticket à chaque observation : cela multiplierait les lignes et les durées. Les deux tables partagent une dimension Service et un calendrier.
| Table | Champs utiles | Contrôle attendu |
|---|---|---|
| Tickets | ticket_id, service_id, type_ticket, priorite, ouvert_a, resolu_a | Identifiant unique ; résolution postérieure à l’ouverture. |
| Tickets | minutes_resolution, sla_minutes, sla_eligible | Durée décomptée selon le calendrier et les pauses convenus ; engagement applicable historisé. |
| HistoriqueStatuts | ticket_id, date_changement, ancien_statut, nouveau_statut | Ordre des événements et règles de réouverture cohérents. |
| Observations | service_id, debut_intervalle, minutes_prevues, minutes_observees, minutes_indisponibles | Intervalles non chevauchants ; inconnues identifiables et indisponibilité dédupliquée. |
Construisons une lecture commune entre informatique et métier.
Parler de mon reporting ITRetenir six indicateurs de service avec un périmètre clair
Chaque taux doit conserver son numérateur, son dénominateur et sa période. Une valeur sans base de calcul est difficile à interpréter.
| Indicateur | Calcul | Précautions |
|---|---|---|
| Incidents ouverts | Nombre distinct de tickets incidents ouverts dans la période | Demandes exclues ; comparer des périodes de durée comparable. |
| Incidents restant ouverts | Incidents ouverts avant la borne de fin et non résolus à cette borne | Utiliser l’historique pour les réouvertures ; c’est un stock à date. |
| Délai médian de résolution | Médiane des minutes_resolution des incidents résolus dans la période | Même convention de temps ; tickets encore ouverts exclus et visibles dans le stock. |
| Résolution dans le délai convenu | Incidents éligibles résolus à temps / incidents éligibles résolus × 100 | Pas de délai absent assimilé à une réussite ; afficher aussi les retards toujours ouverts. |
| Disponibilité observée | (minutes_observees − minutes_indisponibles) / minutes_observees × 100 | Par service et fenêtre convenue ; inconnues exclues, jamais déclarées disponibles. |
| Couverture de mesure | minutes_observees / minutes_prevues × 100 | Accompagne la disponibilité ; une couverture faible limite la conclusion. |
Vérifier les données avant de commenter la performance
Contrôlez les doublons de tickets, les priorités inconnues, les dates inversées et les fuseaux horaires. Pour la durée de résolution, un simple écart entre deux horodatages ne suffit pas si l’engagement ne court qu’en heures ouvrées ou prévoit des pauses.
Comparez le stock initial + ouvertures − résolutions aux tickets ouverts à la clôture, en isolant réouvertures, annulations et reclassements. Rapprochez ensuite les interruptions mesurées et les incidents majeurs connus ; un ticket absent ne prouve pas une absence d’interruption.
- Dédupliquer les interruptions simultanées avant de sommer leurs durées.
- Conserver la couverture de mesure et la date de dernière collecte.
- Exclure les descriptions contenant mots de passe, secrets ou données personnelles inutiles.
- Faire valider les exceptions et l’impact métier par le propriétaire du service.
Avec Excel : partir d’un export de tickets et d’une feuille de contrôles
Actualisez d’abord les sources, ensuite les tableaux et contrôles. Archivez un instantané validé : les tickets évoluent et un export actuel ne reconstitue pas toujours fidèlement le passé.
Importer l’export avec Power Query, typer les horodatages et rapprocher service_id du référentiel. Écarter les doublons après avoir déterminé la bonne version de chaque ticket.
Créer des requêtes distinctes pour les incidents ouverts, les résolus et le stock à date. Paramétrer les bornes de période plutôt que filtrer seulement le mois d’ouverture.
Produire les durées selon les conventions validées. Si le système de tickets fournit déjà un compteur SLA fiable, conserver ce compteur et sa définition.
Construire un tableau croisé par service et priorité. Afficher ouverts, résolus et stock ; calculer le respect du délai à partir des nombres éligibles.
Ajouter la disponibilité issue de la supervision dans une synthèse séparée, puis rédiger les actions à engager.
Avec Access : conserver un historique et éditer le compte rendu
Reliez Service à Tickets, puis Tickets à HistoriqueStatuts avec intégrité référentielle. Contrôlez les identifiants dans une table temporaire avant intégration. Conservez la supervision dans Observations.
La requête compte les incidents résolus par service : début inclus, fin exclue. Créez un état présentant les résultats et les actions. Les engagements et le stock historique nécessitent leurs propres requêtes. Restreignez l’accès à la base et diffusez uniquement le compte rendu autorisé.
PARAMETERS [Debut] DateTime, [Fin] DateTime;
SELECT service_id, Count(ticket_id) AS IncidentsResolus
FROM Tickets
WHERE type_ticket = 'incident'
  AND resolu_a >= [Debut]
  AND resolu_a < [Fin]
GROUP BY service_id;
Avec Python et Streamlit : explorer la résolution par service
Le prototype suivant utilise cinq tickets simulés, tous résolus en septembre 2026. Il exclut la demande et l’incident sans engagement applicable du calcul du délai respecté. Installez pandas et streamlit avec python -m pip install pandas streamlit, enregistrez app.py puis exécutez python -m streamlit run app.py.
Les minutes de l’exemple sont déjà décomptées selon une convention unique. Dans une application réelle, connectez le système de tickets, contrôlez les calendriers et ajoutez authentification, accès par service et journal de collecte.
import pandas as pd
import streamlit as st

df = pd.DataFrame([
    ["I01", "Facturation", "incident", 60, 120, True],
    ["I02", "Facturation", "incident", 180, 120, True],
    ["I03", "Messagerie", "incident", 30, 60, True],
    ["D01", "Messagerie", "demande", 300, 600, True],
    ["I04", "Messagerie", "incident", 90, None, False],
], columns=["ticket_id", "service_id", "type_ticket",
    "minutes_resolution", "sla_minutes", "sla_eligible"])
st.title("Reporting IT — septembre 2026 simulé")
choix = st.selectbox("Service", ["Tous", *df.service_id.unique()])
vue = df if choix == "Tous" else df[df.service_id == choix]
incidents = vue[vue.type_ticket == "incident"]
eligibles = incidents[
    incidents.sla_eligible & incidents.sla_minutes.notna()
    & incidents.minutes_resolution.notna()]
nb = len(eligibles)
respectes = (eligibles.minutes_resolution <= eligibles.sla_minutes).sum()
st.metric("Incidents résolus", len(incidents))
st.metric("Incidents éligibles au délai", nb)
st.metric("Résolus dans le délai",
          f"{100 * respectes / nb:.1f} %" if nb else "Non calculable")
st.dataframe(vue, hide_index=True)
Avec Power BI : relier les vues de support et de pilotage
Créez les dimensions Service et Date, reliées aux faits Tickets et Observations. Une vue de résolution doit filtrer la date de résolution ; une vue d’entrées filtre la date d’ouverture. Utilisez des dimensions de dates séparées ou des relations activées explicitement dans les mesures.
La mesure ci-dessous suppose que la période de résolution filtre déjà Tickets. Formatez-la en pourcentage et affichez le nombre de tickets éligibles à côté. Pour un service local, configurez la passerelle si elle est nécessaire, les identifiants et l’actualisation après la collecte.
- Distribuer des vues adaptées au support, aux responsables métier et à la direction.
- Tester les droits avec un compte lecteur, y compris les possibilités d’export.
- Afficher les échecs de collecte et la fraîcheur ; un graphique ancien ne doit pas paraître actuel.
Taux de resolution dans le delai =
VAR Eligibles =
    FILTER (
        Tickets,
        Tickets[type_ticket] = "incident"
            && Tickets[sla_eligible] = TRUE ()
            && NOT ISBLANK ( Tickets[resolu_a] )
            && NOT ISBLANK ( Tickets[sla_minutes] )
            && NOT ISBLANK ( Tickets[minutes_resolution] )
    )
RETURN
    DIVIDE (
        COUNTROWS ( FILTER ( Eligibles,
            Tickets[minutes_resolution] <= Tickets[sla_minutes] ) ),
        COUNTROWS ( Eligibles )
    )
Transformer le compte rendu en décisions de service
Pour chaque service, présentez le résultat, son impact et l’action attendue. Si des incidents de facturation ralentissent la clôture, cherchez les causes récurrentes à corriger.
La revue se termine par des actions, un responsable et une échéance. Au cycle suivant, examinez les effets et les retards pour arbitrer entre continuité, support, maintenance et évolution.
Exemple pédagogique
Exemple illustratif : deux pourcentages pour lire la disponibilité
Un service doit être mesuré pendant 10 000 minutes sur la période. Les observations exploitables couvrent 9 900 minutes ; 90 minutes sont indisponibles, sans chevauchement. La disponibilité observée est (9 900 − 90) / 9 900 = 99,09 %, avec une couverture de mesure de 99 %. Les 100 minutes inconnues ne sont pas supposées disponibles.
Le stock initial compte 40 incidents. Cent sont ouverts et 110 résolus, sans réouverture ni annulation : le stock final est 30. Sur 80 incidents résolus ayant un délai applicable, 72 le respectent : 90 %. Ce taux ne décrit pas les incidents encore ouverts, qui font l’objet d’une liste de retards distincte.
À propos de cet exemple : Données simulées destinées à expliquer la méthode, distinctes du petit jeu du prototype. Aucun engagement de disponibilité ni résultat client n’est déduit de cet exemple.
Accompagnement proportionné
Relier les données informatiques au service attendu par l’activité
Je peux cadrer vos indicateurs, rapprocher tickets et sources de supervision, puis construire un reporting que les équipes savent produire et commenter.
Livrables possibles
- Catalogue des services et définitions des indicateurs.
- Modèle de données, contrôles et règles de période.
- Tableaux adaptés aux audiences et revue des actions.
- Procédure de collecte, d’actualisation et de reprise.
Limites et dépendances : Les engagements de service, exclusions et priorités restent à valider avec vos responsables métier, informatique et vos contrats applicables.
Questions fréquentes
Les points à clarifier avant de décider
Pourquoi séparer incidents et demandes ?
Ils ne décrivent pas le même besoin : rétablir un service et réaliser une prestation standard. Les mélanger peut donner l’impression que la résolution s’améliore simplement parce que davantage de demandes faciles sont traitées.
Peut-on calculer la disponibilité avec les seuls tickets ?
Les tickets apportent le contexte et l’impact, mais leur absence ne prouve pas la disponibilité. Utilisez des observations ou tests couvrant les services attendus, puis présentez la couverture de mesure et les périodes inconnues.
Quel outil choisir pour un reporting informatique ?
Excel convient à une production périodique simple ; Access peut organiser un historique structuré ; Python et Streamlit permettent des analyses spécifiques ; Power BI facilite des vues partagées. La qualité des conventions et des sources prime sur le nombre de graphiques.
Sources et vérification
Références utilisées
.
- Microsoft Learn — Architecture strategies for defining reliability targets — s’ouvre dans un nouvel ongletObjectifs de service définis avec le métier, fenêtres de mesure et distinction entre objectifs et engagements.
- Microsoft Support — Importer des données avec Power Query — s’ouvre dans un nouvel ongletImport et préparation des exports dans Excel.
- Microsoft Support — Créer, modifier ou supprimer une relation — s’ouvre dans un nouvel ongletRelations entre tables et intégrité des identifiants dans Access.
- Streamlit — st.metric — s’ouvre dans un nouvel ongletAffichage d’indicateurs dans le prototype Python.
- Microsoft Learn — Manage your data source — import and scheduled refresh — s’ouvre dans un nouvel ongletConfiguration des sources et de la passerelle pour l’actualisation planifiée.